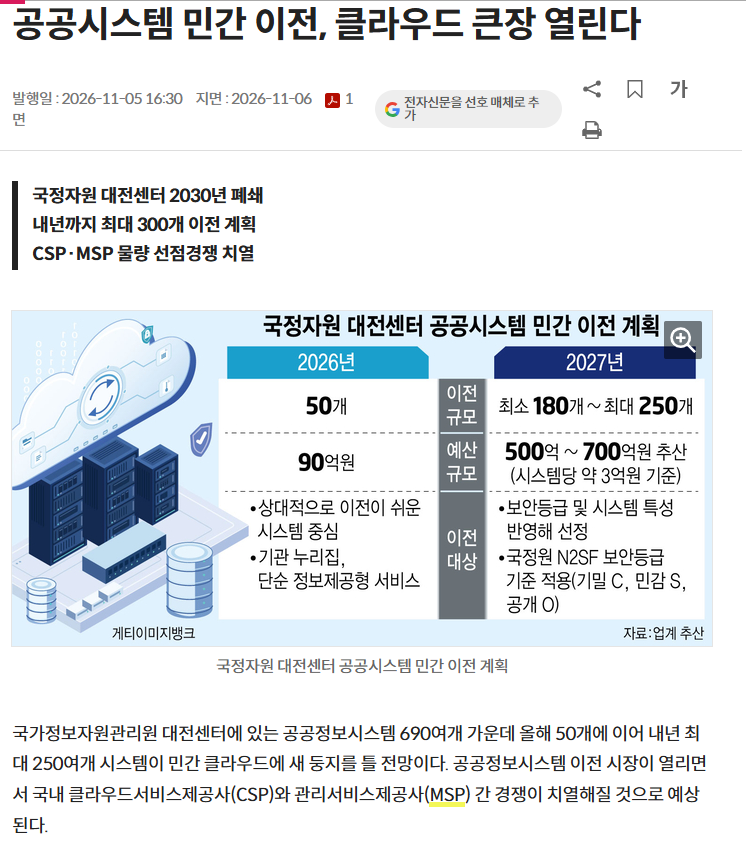
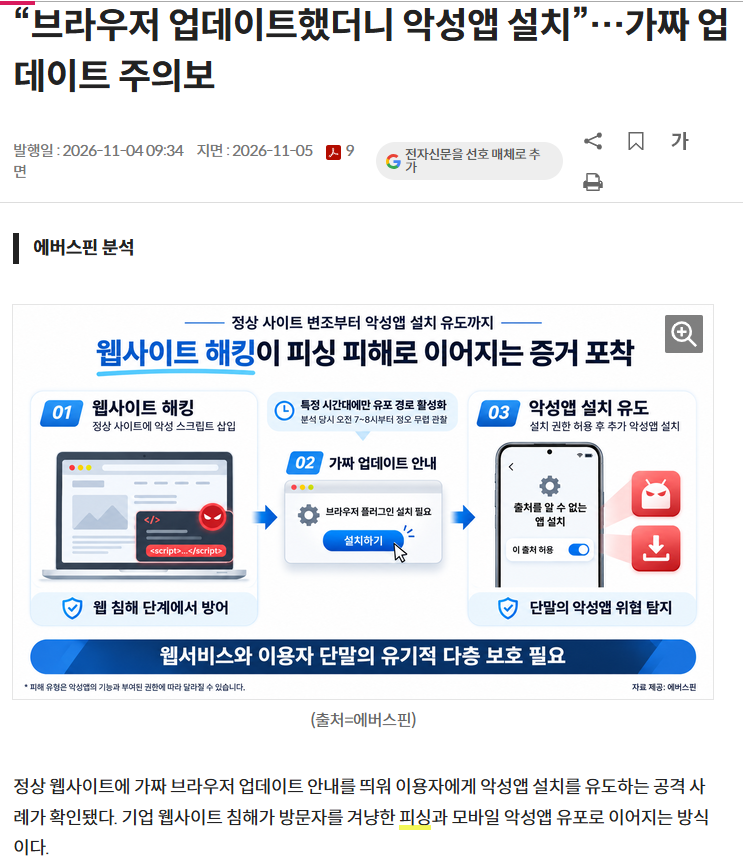
1. 한줄 정의

  • 차분 프라이버시 (Differential Privacy, DP): 데이터셋에 특정 개인의 데이터가 포함되었는지 여부와 무관하게 통계적 분석 질의 결과의 확률 분포가 수학적으로 거의 동일하도록 제어된 확률적 노이즈를 주입하는 프라이버시 보호 모델.
  • 공격자가 보유한 임의의 사전 지식(Background Knowledge)이나 결합 공격에 관계없이 개인정보 유출 위험 상한선을 보장하는 엄밀한 수학적 정량화 기법.

2. 특징, 배경, 목적, 해결

  • 등장 배경: $k$-익명성($k$-Anonymity), $l$-다양성($l$-Diversity) 등 전통적 휴리스틱 비식별 조치가 외부 보조 정보와의 결합 공격(Linkage Attack)이나 동질성 공격에 의해 재식별되는 구조적 취약점 노출.
  • 해결 과제: 공격자의 연산 능력 및 외부 데이터 보유량에 대한 가정을 완전히 배제하고, "단일 개인이 데이터셋에 추가/삭제되어도 결과가 달라지지 않는다"는 통계적 불가구분성(Indistinguishability) 확립.
  • 중요성: 빅데이터 통계 분석 및 AI 모델 학습(DP-SGD) 시 데이터의 유용성(Utility)과 개인정보 보호(Privacy) 간의 트레이드오프를 수치적 파라미터($\epsilon, \delta$)로 정밀 통제 가능.

3. 핵심 개념

  • 인접 데이터셋 (Neighboring Datasets, $D, D'$): 전체 레코드 중 단 하나의 개인 데이터(레코드 1건)만 차이가 나는 두 데이터셋 ($\Vert{}D \oplus D'\Vert{} = 1$).
  • 프라이버시 예산 (Privacy Budget, $\epsilon$): 개인정보 보호 수준을 결정하는 양수 파라미터로, 값이 작을수록 보호 강도가 높고(노이즈 증가) 유용성은 감소.
  • 완화 계수 (Relaxation Parameter, $\delta$): $(\epsilon, \delta)$-DP에서 엄격한 $\epsilon$-DP 보장이 깨질 수 있는 극소 확률(Failure Probability).
  • 전역 민감도 (Global Sensitivity, $\Delta f$): 인접한 두 데이터셋에 동일 질의 $f$를 수행했을 때 발생할 수 있는 결과값의 최대 차이 ($\Delta f = \max \Vert{}f(D) - f(D')\Vert{}$).
  • 노이즈 메커니즘 (Noise Mechanism): 질의 결과에 무작위 값을 더하는 방식으로 라플라스(Laplace, $L_1$ 민감도 기반), 가우시안(Gaussian, $L_2$ 민감도 기반) 메커니즘이 대표적.
  • 결합 정리 (Composition Theorem): 동일 데이터에 복수 질의 수행 시 소모되는 누적 프라이버시 손실($\sum \epsilon_i$)을 추적하고 제한하는 수학적 성질.
  • 사후 처리 불변성 (Post-Processing Immunity): DP 알고리즘이 출력한 결과물은 이후 어떠한 추가 분석이나 가공을 거쳐도 프라이버시 보장 수준이 약화되지 않는 특성.

4. 동작 원리 / 구조

  • 수학적 정의 ($\epsilon$-DP):
    임의의 인접 데이터셋 $D, D'$와 가능한 모든 출력 결과 집합 $S \subseteq \text{Range}(\mathcal{M})$에 대해:

$$\Pr[\mathcal{M}(D) \in S] \le e^{\epsilon} \times \Pr[\mathcal{M}(D') \in S]$$

  • 동작 흐름: 사용자의 통계 질의에 대해 참값(True Answer)을 계산한 뒤, 질의 함수의 민감도($\Delta f$)와 할당된 프라이버시 예산($\epsilon$)에 반비례하는 확률 분포 노이즈를 덧셈 연산하여 반환.
[ Data Source (Dataset D) ]  ─────── (개인 A 포함) ───────┐
                                                           ▼
[ Neighboring Data (D') ]    ─────── (개인 A 제외) ──> [ Query f(D) 계산 ]
                                                           │
                                                           ▼ (참값: True Answer)
                                                      [ f(D) = 1,000 ]
                                                           │
[ Noise Generation Engine ]                                │
  - Global Sensitivity (Δf)                                ▼ (+)
  - Privacy Budget (ε)       ──────> [ Noise Sample : Lap(Δf / ε) ]
                                                           │
                                                           ▼
                                                [ Sanitized Output M(D) ]
                                                "1,003" (개인 A 존재 여부 은닉)

5. 관련 기술

  • 상위 기술: 개인정보 보호기술(PET), 프라이버시 보존형 머신러닝(PPML), 정보이론(Information Theory).
  • 연관 기술: 연합학습(Federated Learning), 합성 데이터(Synthetic Data), 암호학적 기밀 컴퓨팅(TEE, 동형암호).
  • 하위 기술 분류:
  • 중앙형 차분 프라이버시 (CDP, Central DP): 신뢰할 수 있는 중앙 서버가 원천 데이터를 보유하고 최종 질의 결과에 노이즈를 일괄 주입하는 모델.
  • 로컬 차분 프라이버시 (LDP, Local DP): 중앙 서버를 신뢰하지 않고 각 클라이언트 디바이스 단에서 원시 데이터를 노이즈로 교란(Randomized Response)한 후 전송하는 모델.
  • DP-SGD (Differentially Private SGD): 딥러닝 역전파 시 각 배치의 그래디언트를 클리핑(L2 Clipping)한 후 가우시안 노이즈를 주입하여 모델 파라미터 유출을 차단하는 학습 알고리즘.
  • Renyi DP (RDP) / Moment Accountant: 딥러닝 반복 훈련 시 프라이버시 예산 누적 손실을 정밀하게 타이트하게 계산하는 진화된 분석 프레임워크.

6. 비교 기술 (중앙형 CDP vs 국소형 LDP vs $k$-익명성)

비교 항목 전통적 $k$-익명성 ($k$-Anonymity) 중앙형 차분 프라이버시 (CDP) 로컬 차분 프라이버시 (LDP)
보안 원천 식별자 제거 및 준식별자 일반화/범주화 수학적 확률 분포 노이즈 주입 클라이언트 단의 데이터 교란(난수화)
중앙 서버 신뢰도 중앙 서버를 완전히 신뢰해야 함 중앙 수집자를 신뢰해야 함 중앙 수집자조차 신뢰 불필요 (Zero Trust)
재식별 공격 방어 배경 지식 결합 공격 시 취약 수학적으로 원천 방어 (사전 지식 무관) 수학적으로 원천 방어 (디바이스 단 노출 제로)
데이터 정확도(Utility) 보통 (데이터 왜곡 발생) 우수 (중앙에서 통계적 노이즈 최소화) 낮음 (노이즈 누적으로 대량의 모수 필요)
적용 영역 정적 공공 데이터셋 개방 Census 센서스 통계, AI 모델 학습(DP-SGD) 모바일 단말 텔레메트리 (Apple/Google)

7. 장점 및 효과

  • 수학적으로 입증 가능한 안전성: 공격자의 사전 지식이나 계산 능력에 구애받지 않는 결정론적 보안 한계 보장.
  • 구성 가능성(Composability): 복수의 분석 질의나 다단계 파이프라인 수행 시 누적되는 프라이버시 유출 총량을 정량적 공식으로 사전 통제 가능.
  • 사후 가공에 대한 내성: 한 번 차분 프라이버시 처리를 거쳐 방출된 통계량은 기계학습 모델링이나 역공학 등 2차 가공을 거쳐도 안전성이 유지됨.

8. 단점 및 한계

  • 정확도(Utility) 저하: 프라이버시 보호 강도를 높일수록($\epsilon \downarrow$) 노이즈가 급증하여 소규모 데이터셋이나 아웃라이어(이상치) 분석 정확도가 심각하게 훼손.
  • 프라이버시 예산 소진(Budget Exhaustion): 동일 데이터셋에 대해 지속적으로 질의를 수행하면 누적 예산이 고갈되어 더 이상 분석 서비스를 제공할 수 없는 가용성 문제 발생.
  • 공정성 및 소수자 왜곡(Fairness Issue): 노이즈 주입 시 표본 수가 적은 소수자/희귀 그룹의 데이터가 노이즈에 묻혀 의사결정 편향이 증폭될 위험.

9. 적용 사례

  • 미국 인구조사국 (US Census Bureau): 2020년 센서스 인구 통계 발표 시 재식별 결합 공격을 차단하기 위해 차분 프라이버시 프레임워크 전면 채택.
  • 글로벌 빅테크 모바일 수집 (Apple, Google): iOS 키보드 단어 추천 빈도 수집 및 Chrome 브라우저의 원격 텔레메트리(RAPPOR) 수집 시 Local DP(LDP) 적용.
  • 의료/금융 생성형 AI 학습: 환자 의료 기록이나 금융 거래 원장 기반으로 LLM이나 확산 모델을 학습시킬 때 개인정보 역추적을 방어하기 위해 DP-SGD 도입.

10. 고려사항 (CSF)

  • 민감도($\Delta f$) 정밀 계산: 질의 함수의 민감도를 과대 추정하면 불필요한 과잉 노이즈가 들어가고, 과소 추정하면 프라이버시 보증이 무력화되므로 엄밀한 수학적 유도 필수.
  • 적정 예산($\epsilon$) 합의: 학술적으로는 $\epsilon \le 1$을 권장하나 실제 산업계에서는 분석 효용성을 위해 $\epsilon \in [2, 10]$ 수준을 절충하여 정책적 SLA 수립.
  • Budget Tracking 시스템 구축: 다중 테넌트 질의 환경에서 질의자별 누적 사용 예산을 실시간 차감하고 한도 도달 시 질의를 거부하는 API 게이트웨이 거버넌스 구현.

11. 발전 방향 및 시사점

  • DP-SGD의 연산 최적화: 딥러닝 배치 단위가 아닌 샘플별 그래디언트 클리핑(Per-sample Clipping)으로 인한 GPU 연산 속도 저하를 컴파일러 커널 최적화로 가속.
  • 합성 데이터(DP-Synthetic Data) 결합: 원본 데이터에 매번 질의하는 대신, DP 제약 하에 훈련된 생성 모델로 합성 데이터셋을 1회 생성하여 무제한 분석에 활용.
  • 암호화 기술(SMC/TEE)과의 융합: LDP의 낮은 정확도 한계를 극복하기 위해 참여자 데이터를 SMC나 TEE 셔플러(Shuffle Model)로 중간 익명화하여 작은 노이즈로도 높은 DP 효과를 얻는 셔플 모델(Shuffle DP) 표준화.

12. 기술 관계도

[고전적 비식별 한계]
  │ (넷플릭스 프라이즈 재식별 등 보조 정보 결합 공격으로 k-익명성 무력화)
  ▼
[Dwork의 차분 프라이버시 정립 (2006)]
  │ (인접 데이터셋 간 확률 분포 비율 e^ε 수학적 불인식성 정의)
  ▼
[기본 노이즈 메커니즘]
  ├─ Laplace Mechanism (L1 노이즈 기반, 순수 ε-DP)
  └─ Gaussian Mechanism (L2 노이즈 기반, 완화된 (ε, δ)-DP)
  ▼
[수집 패러다임 분기]
  ├─ Central DP (중앙 서버 신뢰 기반 정밀 통계 산출)
  └─ Local DP (Apple, Google 모바일 텔레메트리 단말 교란)
  ▼
[딥러닝 및 대규모 AI 확장]
  ├─ DP-SGD (Abadi et al., 그래디언트 클리핑 + 노이즈 주입 학습)
  ├─ Moments Accountant / Renyi DP (복합 반복 훈련 예산 정밀 추적)
  └─ Shuffle DP (SMC/TEE 연계로 LDP 대비 효용성 극대화)

출처

  • Dwork, C., & Roth, A., The Algorithmic Foundations of Differential Privacy (Foundations and Trends in Theoretical Computer Science)
  • Abadi et al., Deep Learning with Differential Privacy (ACM CCS 2016 - DP-SGD Specification)
  • Mironov, I., Rényi Differential Privacy (IEEE CSF 2017)
  • 개인정보보호위원회: 차분 프라이버시(Differential Privacy) 활용 안내서

1. 한줄 정의

  • 개인정보 보호기술 (PET, Privacy-Enhancing Technologies): 데이터의 라이프사이클(수집, 저장, 처리/활용, 파기) 전 과정에서 개인정보 침해 위험을 사전에 차단하면서 데이터의 분석적 유용성(Utility)을 안전하게 활용하도록 지원하는 하드웨어·소프트웨어 기술 총칭.
  • 프라이버시 바이 디자인(Privacy by Design) 철학에 기반하여 규제 준수(GDPR, 개인정보보호법)를 보장하고, 민감 데이터를 노출 없이 연산·결합·공유할 수 있게 하는 데이터 경제 시대의 필수 신뢰 인프라.

2. 특징, 배경, 목적, 해결

  • 등장 배경: 인공지능(AI), 빅데이터, 클라우드 확산으로 데이터 결합 및 분석 수요가 급증했으나, 기존 사후 비식별 조치(마스킹, 단순 가명처리)만으로는 데이터 재식별 위험 및 내부자 유출 차단 불가.
  • 해결 과제: 데이터 프라이버시(Privacy)와 데이터 활용 가치(Utility) 간의 근본적 트레이드오프(Trade-off)를 해결하고, 데이터 이동 및 암호화 해제 없이도 안전하게 연산 가능한 환경 구현.
  • 중요성: 데이터 3법 개정 및 글로벌 규제 강화 환경에서 의료, 금융, 공공 등 이종 산업 간 마이데이터 결합과 프라이버시 보존형 머신러닝(PPML)을 실현하는 핵심 기저 기술.

3. 핵심 개념

  • Privacy by Design (PbD): 시스템 기획·설계 초기 단계부터 개인정보 보호를 기본값(Default)으로 내재화하는 공학적 접근법.
  • 동형암호 (Homomorphic Encryption): 데이터를 복호화하지 않고 암호화된 상태 그대로 덧셈·곱셈 연산을 수행할 수 있는 차세대 암호 체계 (CKKS, BGV 등).
  • 차분 프라이버시 (Differential Privacy): 데이터셋에 특정 개인의 데이터가 포함되었는지 여부와 무관하게 질의 결과의 통계적 분포가 유사하도록 수학적 노이즈(Laplace, Gaussian)를 주입하는 기법.
  • 보안 다자간 연산 (SMC / MPC): 여러 참여자가 각자의 비밀 입력값을 외부에 노출하지 않고 공동의 연산 함수($f(x_1, \dots, x_n)$)를 비밀 분산(Secret Sharing)을 통해 산출하는 기술.
  • 연합학습 (Federated Learning): 원시 데이터(Raw Data)를 중앙 서버로 전송하지 않고 각 로컬 디바이스에서 분산 학습한 모델 가중치(Weight)만 집계 서버로 전송해 글로벌 모델을 갱신하는 분산 ML 기법.
  • 신뢰 실행 환경 (TEE / Confidential Computing): CPU/서버 내부 메모리에 하드웨어 격리 영역(Enclave)을 생성하여 OS나 하이퍼바이저조차 접근할 수 없도록 메모리 암호화를 제공하는 하드웨어 기반 보안 기술 (Intel SGX, AMD SEV).
  • 영지식 증명 (Zero-Knowledge Proof): 증명자가 자신의 비밀 정보(Secret)를 검증자에게 직접 누설하지 않고도 "해당 비밀 정보를 알고 있다는 사실"만을 수학적으로 증명하는 기법 (zk-SNARKs).
  • 합성 데이터 (Synthetic Data): 실제 개인정보 원천 데이터를 사용하는 대신, 원본의 통계적 패턴과 상관관계를 보존하도록 생성형 모델(GAN, Diffusion)로 합성한 인공 데이터셋.

4. 동작 원리 / 구조

  • 동작 원리: 데이터 처리 패러다임에 따라 암호학적(동형암호, SMC), 하드웨어 격리형(TEE), 알고리즘 분산형(연합학습, 차분 프라이버시) 계층이 결합된 프라이버시 보존형 데이터 협업 파이프라인 구축.
[ Data Providers (의료기관, 금융사 등) ]
  ┌─────────────────────────────────────────────────────────┐
  │ Local Data Storage                                      │
  │ - Raw Sensitive Data (외부 반출 금지)                   │
  └─────────────┬─────────────────────────────┬─────────────┘
                │                             │
    [ 1. Local Protection ]       [ 2. Decentralized Compute ]
    ├─ Differential Privacy       ├─ Federated Learning (로컬 학습)
    │  (통계 질의 시 노이즈 주입)   │  (가중치/그래디언트만 추출)
    └─ Synthetic Data Generation  └─ Secret Sharing (MPC 분할)
                │                             │
                └──────────────┬──────────────┘
                               ▼
[ Secure Processing & Aggregation Layer (중앙 플랫폼 / 클라우드) ]
  ┌─────────────────────────────────────────────────────────┐
  │ Confidential Computing (TEE: Intel SGX / AMD SEV)      │
  │  - Hardware Encrypted Memory Enclave                    │
  ├─────────────────────────────────────────────────────────┤
  │ Cryptographic Computation Layer                         │
  │  - Homomorphic Encryption Engine (Encrypted Matrix Mul) │
  │  - Secure MPC Aggregator (Secret Sharing Summation)     │
  └────────────────────────────┬────────────────────────────┘
                               ▼
[ Safe Analytical Outputs ]
  ├─ Privacy-Preserving Insights (개인정보 노출 없는 통계치)
  ├─ Global AI Foundation Model (개인정보 학습 방지된 연합 모델)
  └─ Zero-Knowledge Attestation (신원 증명만 완료된 인증 토큰)

5. 관련 기술

  • 상위 기술: 정보보안(Information Security), 암호학(Cryptography), 데이터 거버넌스(Data Governance).
  • 연관 기술: 블록체인(Decentralized Identity / DID), 마이데이터(MyData), 생성형 AI(Generative AI), 기밀 컴퓨팅(Confidential Computing).
  • 하위 기술 분류:
  • 암호학적 기술 (Cryptographic): 완전동형암호(FHE), 보안 다자간 연산(SMC/Garbled Circuit), 영지식 증명(zk-STARKs).
  • 하드웨어 기반 기술 (Hardware-enforced): 기밀 가상머신(Confidential VM), TEE(Trusted Execution Environment), TPM.
  • 통계 및 분산 알고리즘 기술 (Statistical & Distributed): 국소/글로벌 차분 프라이버시(LDP/CDP), 연합학습(FedAvg, FedProx), 비식별화(k-익명성, l-다양성, t-근접성).
  • 데이터 생성형 기술 (Generative): 조건부 GAN(CTGAN), 프라이버시 제약 기반 확산 모델(DP-Diffusion).

6. 비교 기술 (PET 핵심 4대 기술 비교)

비교 항목 동형암호 (Homomorphic Encryption) 보안 다자간 연산 (SMC) 신뢰 실행 환경 (TEE) 차분 프라이버시 (Differential Privacy)
보안 원천 고난도 격자 기반 수학적 암호화 비밀 분산 및 통신 프로토콜 하드웨어 기반 CPU Enclave 격리 수학적 확률 분포 노이즈 주입
연산 데이터 상태 완전 암호화 상태 연산 조각화(Share)된 상태 분산 연산 Enclave 내부에서 일시적 복호화 연산 평문 데이터에 노이즈를 섞어 출력
연산 성능/지연 매우 느림 (수십~수천 배 오버헤드) 보통~느림 (네트워크 통신 병목) 매우 빠름 (네이티브 대비 90~95% 속도) 매우 빠름 (단순 노이즈 덧셈 연산)
결과 정밀도 완벽한 수학적 정밀도 유지 완벽한 수학적 정밀도 유지 완벽한 수학적 정밀도 유지 노이즈로 인한 정확도(Utility) 손실
하드웨어 의존성 전용 가속기(FPGA/ASIC) 권장 네트워크 대역폭 및 토폴로지 의존 특정 CPU 아키텍처 필수 종속 하드웨어 독립적 (소프트웨어 구현)
적합한 유즈케이스 외부 클라우드 단일 아웃소싱 연산 2~3개 기관 간 동등 결합 분석 대규모 AI 추론/학습 기밀 서빙 대규모 인구 통계 조사, 추천 시스템

7. 장점 및 효과

  • 데이터 공유 장벽 해소: 데이터 유출 우려로 결합이 불가능했던 금융·의료·통신 데이터 간의 안전한 크로스 도메인 결합 활성화.
  • 글로벌 규제 준수(Compliance): GDPR, HIPAA, 국내 개인정보보호법 상의 가명정보 처리 및 데이터 주권(Data Sovereignty) 요건 충족.
  • 공급망 및 클라우드 신뢰 확보: 제3자 클라우드 제공자(CSP) 및 인프라 관리자조차 내부 데이터를 열람할 수 없는 Zero Trust Data Protection 달성.

8. 단점 및 한계

  • 연산 및 통신 오버헤드: 동형암호의 부트스트래핑(Bootstrapping) 연산 지연, SMC의 노드 간 다자간 네트워크 트래픽 폭증.
  • 정확도-프라이버시 상충: 차분 프라이버시 도입 시 프라이버시 예산($\epsilon$)을 엄격히 잡을수록 데이터 분석 왜곡 심화.
  • 하드웨어 부채널 공격(Side-Channel Attack): TEE 계층에 대한 캐시 타이밍 공격, 전력 분석 공격 등 하드웨어 마이크로아키텍처 취약점 상존.

9. 적용 사례

  • 의료 및 바이오 협업: 다수 대학병원의 환자 EMR 데이터를 원외 반출 없이 연합학습으로 학습하여 희귀 질환 진단 모델 개발.
  • 금융 사기 탐지(FDS): 서로 다른 복수 은행이 고객 금융 거래 원장을 노출하지 않고 SMC를 통해 공동 자금세탁(AML) 계좌 식별.
  • 빅테크 프라이버시 보존형 텔레메트리: Apple/Google이 모바일 키보드 추천어 수집 시 로컬 차분 프라이버시(LDP)를 적용해 개인 입력값 보호.

10. 고려사항 (CSF)

  • 프라이버시 예산(Privacy Budget, $\epsilon$) 거버넌스: 차분 프라이버시 적용 시 누적 질의에 따른 프라이버시 예산 고갈을 모니터링하는 오딧(Audit) 체계 수립.
  • 하이브리드 아키텍처 설계: 연산량이 큰 행렬 곱셈은 TEE에서 고속 처리하고, 키 관리는 동형암호나 MPC로 다중화하는 복합 PET 전략 수립.
  • 법적 규제 상등성 검증: 적용된 PET 기술이 현행법상 '익명정보' 또는 '적법한 가명정보'로 법적 효력을 인정받을 수 있는지 규제 샌드박스 연계.

11. 발전 방향 및 시사점

  • 하드웨어 가속기(FHE-ASIC) 표준화: 동형암호의 극심한 연산 지연을 단축하기 위한 인텔, DARPA 주도의 전용 가속 반도체 상용화.
  • 기밀 AI(Confidential AI) 보편화: LLM 서빙 시 프롬프트와 가중치 탈취를 방지하기 위해 GPU(예: NVIDIA H100 TEE) 레벨의 기밀 컴퓨팅 기본 탑재.
  • PET 종합 프레임워크 표준화: ISO/IEC 27557, UN PET Lab 가이드라인을 중심으로 엔터프라이즈 레벨의 PET 도입 표준 인증 규격 확립.

12. 기술 관계도

[초기 비식별화] 고전적 통계적 비식별 조치
  │ (마스킹, 가명화, k-익명성, l-다양성 ➔ 재식별 공격 취약)
  ▼
[수학적·암호학적 프라이버시 태동]
  ├─ Differential Privacy (Laplace/Gaussian 노이즈 수학적 정립)
  ├─ Secure MPC (Yao's Garbled Circuit, Shamir 비밀 분산)
  └─ 동형암호 (Gentry 완전동형암호 1세대 ➔ BGV, CKKS 실용화)
  ▼
[하드웨어 및 분산 인프라 결합]
  ├─ TEE / Confidential Computing (Intel SGX, AMD SEV 하드웨어 격리)
  └─ Federated Learning (Google 분산 모바일 모델 학습)
  ▼
[현대 융합형 프라이버시 인프라]
  ├─ PPML (Privacy-Preserving Machine Learning: 연합학습 + 동형암호/DP)
  ├─ Confidential GPU Computing (GPU 가속기 레벨 메모리 암호화)
  └─ zk-SNARKs 기반 탈중앙 신원 증명 (Zero-Knowledge Identity)

출처

  • UN PET Lab: United Nations Guide on Privacy-Enhancing Technologies for Official Statistics
  • Dwork & Roth, The Algorithmic Foundations of Differential Privacy (Foundations and Trends in Theoretical Computer Science)
  • Confidential Computing Consortium (Linux Foundation): Confidential Computing: Hardware-Based Trust for Global Data Security
  • 개인정보보호위원회: 개인정보 비식별 조치 가이드라인 및 프라이버시 보존형 신기술 활용 안내서

1. 한줄 정의

  • 경사하강법 (Gradient Descent): 모델의 예측값과 실제값 간의 오차를 정의한 비용 함수(Cost/Loss Function)의 그래디언트(기울기 벡터)를 계산하고, 그 반대 방향으로 모델의 파라미터를 반복 갱신하여 손실을 최소화하는 1차 미분(First-order) 기반 수치 최적화 알고리즘.
  • 고차원 가중치 공간에서 국소적인 기울기 정보($-\nabla L$)에 학습률(Learning Rate, $\eta$)을 곱해 전역 또는 국소 최저점(Global/Local Minima)으로 수렴시키는 인공신경망 학습의 핵심 기저 엔진.

2. 특징, 배경, 목적, 해결

  • 등장 배경: 심층 신경망(DNN)과 파운데이션 모델은 수십억~수천억 개의 파라미터 간 비선형 복합 합성함수로 구성되어 있어, 정규 방정식(Normal Equation, $\mathbf{W} = (\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{Y}$)과 같은 해석적(Analytical) 역행렬 계산($\mathcal{O}(D^3)$)이 불가능함.
  • 해결 과제: 해석적 해법 대신 반복적(Iterative) 근사 최적화 방식을 도입하여 고차원 파라미터 공간에서도 계산 가능한 수치해석적 오차 최소화 달성.
  • 중요성: 퍼셉트론, MLP, CNN, Transformer, LLM 등 현대 모든 딥러닝 아키텍처의 역전파(Backpropagation) 기반 가중치 최적화 표준 프레임워크로 기능.

3. 핵심 개념

  • 비용 함수 (Loss / Cost Function, $L(\mathbf{W})$): 정답과 예측값의 오차를 정량화한 최적화 목적 함수 (MSE, Cross-Entropy 등).
  • 기울기 벡터 (Gradient Vector, $\nabla L$): 다변수 손실 함수를 각 가중치로 편미분한 벡터로, 함수값이 가장 가파르게 증가하는 방향을 지시.
  • 학습률 (Learning Rate, $\eta$): 한 번의 반복 스텝에서 가중치를 얼마만큼 갱신할지 결정하는 보폭(Step Size) 하이퍼파라미터.
  • 에포크(Epoch) 및 배치(Batch): 전체 학습 데이터를 순회하는 단위(Epoch)와 1회 가중치 갱신에 사용하는 데이터 표본 크기(Batch Size).
  • 지역 최저점 (Local Minima): 전체 영역의 최솟값이 아니지만 특정 국소 구간에서 기울기가 0이 되어 갇히는 지점.
  • 안장점 (Saddle Point): 어떤 축 방향으로는 극솟값이나 다른 축 방향으로는 극댓값이 되어 기울기가 0에 수렴하는 정체 지점 (고차원 심층 신경망의 주된 정체 요인).
  • 오차역전파 (Backpropagation): 연쇄 법칙(Chain Rule)을 적용하여 출력층의 오차를 입력층 방향으로 거슬러 올라가며 모든 가중치의 그래디언트를 구하는 계산 절차.
  • 학습률 스케줄러 (LR Scheduler): 학습 진행에 따라 $\eta$를 점진적으로 감쇠(Decay)하거나 워밍업(Warmup)하여 안정적 수렴을 유도하는 기법.

4. 동작 원리 / 구조

  • 수학적 갱신 공식:

$$\mathbf{W}{t+1} = \mathbf{W}_t - \eta \cdot \nabla{\mathbf{W}} L(\mathbf{W}_t)$$

  • 동작 절차:
  1. Forward Pass: 입력 데이터 $\mathbf{X}$를 가중치 $\mathbf{W}$로 연산하여 예측값 $\hat{\mathbf{Y}}$ 도출.
  2. Loss Calculation: 손실 함수 $L(\hat{\mathbf{Y}}, \mathbf{Y})$를 통해 오차 산출.
  3. Backward Pass (Chain Rule): 출력 오차에 대한 각 파라미터의 편미분값 $\frac{\partial L}{\partial \mathbf{W}}$ 역방향 전파.
  4. Weight Update: 산출된 그래디언트의 반대 방향으로 학습률 $\eta$를 곱하여 가중치 갱신.
[ 1. 순전파 (Forward Pass) ]
  입력 X ────> [ 레이어 W1 ] ────> [ 레이어 W2 ] ────> 예측값 Y_hat
                                                           │
[ 2. 손실 계산 (Loss Calculation) ]                         │
  실제값 Y ───────────────────────────────────────────────> Loss L(Y_hat, Y)
                                                           │
[ 3. 역전파 (Backward Pass: Chain Rule) ]                  │
  dW1 = ∂L/∂W1 <──── dW2 = ∂L/∂W2 <────────────────────────┘ (편미분 계산)
        │                   │
[ 4. 가중치 갱신 (Weight Update) ]
  W1 ──> W1 - η·dW1   W2 ──> W2 - η·dW2

5. 관련 기술

  • 상위 기술: 수치해석학(Numerical Analysis), 비선형 볼록/비볼록 최적화(Convex/Non-convex Optimization).
  • 연관 기술: 오차역전파(Backpropagation), 연쇄 법칙(Chain Rule), 자동 미분(Autograd), 확률적 샘플링.
  • 하위 기술 (최적화 알고리즘 진화군):
  • SGD (Stochastic Gradient Descent): 단일 표본 단위 갱신.
  • Momentum / NAG: 이전 이동 관성 벡터를 반영하여 협곡 진동 억제.
  • AdaGrad / RMSProp: 파라미터별 갱신 빈도에 따라 적응적(Adaptive) 학습률 적용.
  • Adam / AdamW: 모멘텀(1차 모멘트)과 RMSProp(2차 모멘트)을 결합하고 Weight Decay를 분리한 현대 LLM 표준 옵티마이저.

6. 비교 기술 (데이터 분할 방식별 3대 경사하강법)

비교 항목 배치 경사하강법 (BGD) 확률적 경사하강법 (SGD) 미니배치 경사하강법 (MSGD)
1회 갱신 데이터양 전체 데이터셋 ($N$) 단 1개의 샘플 ($1$) 배치 크기 $B$ (예: 32~4096)
수렴 궤적 매우 매끄럽고 안정적 무작위 요동(Fluctuation) 심함 비교적 안정적이며 적절한 진동
Local Minima 탈출 취약 (정체 지점에서 정지) 우수 (노이즈로 안장점 탈출) 우수 (적정 노이즈로 일반화 달성)
메모리 요구량 (VRAM) 극대화 (대용량 시 OOM 발생) 극소화 (샘플 1개 메모리) VRAM 용량에 맞춰 유연 조절
하드웨어 병렬성 GPU SIMD 병렬화 활용 보통 GPU 병렬 처리 불가능 (순차 갱신) GPU 텐서 코어 병렬 연산 극대화
실제 적용 분야 소규모 선형 모델, 통계 분석 실시간 온라인 학습(Online Learning) 현대 딥러닝/LLM 사전학습 표준

7. 장점 및 효과

  • 대규모 고차원 확장성: 수천억 개 파라미터 공간에서도 각 변수의 편미분 벡터만으로 1차 선형 시간 내 연산 수행 가능.
  • 구현의 단순성 및 범용성: 목적 함수가 미분 가능하기만 하면 어떠한 복합 신경망 구조(CNN, RNN, Transformer)에도 일관되게 적용 가능.
  • 하드웨어 친화적: 행렬 곱 및 벡터 내적 연산으로 귀결되어 GPU/NPU 가속 인프라와 완벽히 결합.

8. 단점 및 한계

  • 학습률 민감성 (Hyperparameter Sensitivity):
  • $\eta$가 너무 크면 발산(Overshooting / Divergence).
  • $\eta$가 너무 작으면 극심한 학습 지연 및 정체.
  • 비볼록(Non-convex) 지형 한계:
  • 심층 신경망의 복잡한 손실 곡면에서 안장점(Saddle Point) 및 불량 국소 최적해(Poor Local Minima)에 갇힐 위험.
  • 기울기 소실 및 폭주 (Vanishing/Exploding Gradient):
  • 계층이 깊어질수록 역전파 도중 그래디언트가 지수적으로 0에 수렴하거나 무한대로 발산.

9. 적용 사례

  • 대규모 언어 모델(LLM) 사전학습: 트랜스포머 기반 모델에서 수조 토큰의 Next-Token Prediction 오차를 줄이기 위해 AdamW 기반 분산 경사하강 수행.
  • 컴퓨터 비전 모델 훈련: ResNet, Vision Transformer의 객체 분류 Cross-Entropy Loss 최소화.
  • 강화학습 정책 최적화: PPO(Proximal Policy Optimization)에서 가치 함수 및 정책 신경망의 기울기 갱신.

10. 고려사항 (CSF)

  • 초기화 및 정규화 결합: 가중치 초기화(He, Xavier) 및 정규화 계층(LayerNorm, RMSNorm)을 통해 역전파 시 그래디언트 스케일 유지.
  • 그래디언트 클리핑 (Gradient Clipping): 폭주(Exploding) 방지를 위해 그래디언트 벡터의 L2-Norm 임계치($\Vert{}\mathbf{g}\Vert{}_2 \le \tau$) 강제 제한.
  • 적응형 스케줄링: Warmup 단계로 초반 불안정성을 억제하고 Cosine Annealing을 통해 학습 후반부 정밀 수렴 유도.

11. 발전 방향 및 시사점

  • 2차 최적화(Second-order) 근사: 계산 비용으로 배제되던 헤시안(Hessian) 곡률 정보를 효율적으로 근사하는 K-FAC, Sophia 등의 옵티마이저 연구 지속.
  • 분산 학습 최적화(Distributed ZeRO): 수천억 파라미터의 옵티마이저 상태(FP32 모멘텀/분산)를 다중 노드에 분할 상주시키는 ZeRO(Zero Redundancy Optimizer) 기술 필수화.
  • 양자화 옵티마이저 (8-bit Optimizer): AdamW 내부의 모멘트 버퍼를 INT8/FP8로 양자화하여 VRAM 사용량을 75% 절감하는 기술 보편화.

12. 기술 관계도

[해석적 해법 한계]
  │ (선형회귀 Normal Eq O(D^3) 역행렬 연산 ➔ 고차원 신경망 적용 불가)
  ▼
[기본 1차 최적화]
  ├─ BGD (Batch Gradient Descent : 안정적이나 OOM 및 정체)
  ├─ SGD (Stochastic GD : 빠르나 무작위 요동 심함)
  └─ Mini-batch GD (MSGD : GPU 병렬화 및 표준 타협점)
  ▼
[관성 및 방향성 개선]
  ├─ Momentum (관성 누적으로 협곡 탈출 및 진동 감쇠)
  └─ Nesterov Accelerated Gradient (NAG : 예상 위치 기반 감속 제어)
  ▼
[보폭(학습률) 적응형 개선]
  ├─ AdaGrad (빈번한 피처 보폭 축소, 후반 학습 멈춤 문제)
  └─ RMSProp (지수이동평균 적용으로 AdaGrad 학습 정체 해소)
  ▼
[현대 표준 융합 옵티마이저]
  ├─ Adam (Momentum 1차 모멘트 + RMSProp 2차 모멘트 융합)
  └─ AdamW (L2 정규화와 가중치 감쇠(Weight Decay) 분리 ➔ LLM 표준)
  ▼
[차세대 분산 및 경량 최적화]
  ├─ ZeRO-Optimizer (DeepSpeed : 옵티마이저 상태 샤딩)
  ├─ 8-bit Adam (메모리 절감 양자화)
  └─ Sophia / K-FAC (경량 2차 곡률 정보 반영 옵티마이저)

출처

  • Goodfellow, Bengio, Courville, Deep Learning (MIT Press) - Chapter 8: Optimization for Training Deep Models
  • Loshchilov & Hutter, Decoupled Weight Decay Regularization (ICLR 2019 - AdamW Specification)
  • Rajbhandari et al., ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (Microsoft, SC20)

1. 한줄 정의

  • 로봇 파운데이션 모델 (Robot Foundation Model / VLA): 멀티모달 센서 입력(시각, 언어, 고유수용감각)을 대규모 사전학습된 트랜스포머에 입력받아 로봇의 저수준 물리적 제어 행동(Action Token)을 직접 생성하는 신체화 인공지능(Embodied AI) 모델.
  • 사전학습된 웹 스케일 시각-언어 모델(VLM)에 로봇 관절 각도, 그리퍼 궤적 등의 행동 공간(Action Space)을 결합하여 다양한 로봇 폼팩터 및 환경에 제로샷/소수샷으로 적응하는 엔드투엔드 기반 모델.


2. 특징, 배경, 목적, 해결

  • 등장 배경: 전통적 로봇 공학의 '인식 $\rightarrow$ 계획 $\rightarrow$ 제어' 파이프라인 분립으로 인한 누적 오차 발생, 환경 변화에 취약한 폐쇄 루프 프로그래밍 한계, 로봇 물리 데이터 획득의 고비용성.
  • 해결 과제: 대규모 웹 시각·언어 데이터의 상식적 지식(Common-sense)을 물리 세계의 모터 제어 신호와 정렬(Alignment)하여, 미확인 물체와 비정형 환경에서도 유연한 작업 일반화 달성.
  • 중요성: 휴머노이드, 매니퓰레이터, 이동 로봇 등 다종 이기종 로봇 하드웨어의 두뇌 역할을 표준화하여 차세대 Physical AI 산업 생태계를 견인하는 핵심 동력.

3. 핵심 개념

  • VLA (Vision-Language-Action): 시각 입력(RGB-D), 자연어 명령, 로봇 물리 제어 토큰을 단일 시퀀스 모델 내에서 통합 처리하는 아키텍처.
  • Action Tokenization: 연속적인 엔드이펙터 6DoF 포즈 및 그리퍼 개폐 제어 값을 이산형(Discrete) 토큰으로 양자화하여 자연어 토큰처럼 예측하는 기법.
  • Embodied AI (신체화 인공지능): 소프트웨어 가상 공간을 벗어나 물리적 하드웨어 본체(Body)를 통해 현실 물리 법칙(중력, 마찰, 접촉력)과 상호작용하는 지능.
  • Sim-to-Real Transfer: 물리 엔진 기반 시뮬레이터(Isaac Sim 등)에서 합성 궤적을 대량 생성한 후 도메인 무작위화(Domain Randomization)를 통해 실물 로봇으로 전이하는 기술.
  • Diffusion Policy: 복잡한 다중 모달(Multimodal) 행동 분포를 노이즈 제거 확산 과정으로 정밀하게 모델링하는 로봇 제어 정책.
  • Teleoperation & Cross-Embodiment: 인간 원격 조작 데이터셋(Open X-Embodiment)을 활용하여 서로 다른 팔 길이와 자유도를 지닌 로봇 간 지식을 전이하는 학습 패러다임.

4. 동작 원리 / 구조

  • 동작 원리: 로봇 카메라 영상과 작업 명령어를 임베딩한 후, 사전학습된 멀티모달 백본을 통해 시각적 이해와 고수준 작업 계획(High-level Planning)을 수립하고, 이를 저수준 제어기(Low-level Action Chunking/Diffusion Policy)로 디코딩하여 모터 액추에이터를 구동함.
[ Multi-modal Inputs ]
 ├─ Vision Stream : RGB Camera / Depth Map (Observation O_t)
 ├─ Language Task : Natural Language Prompt ("사과를 집어 바구니에 넣어줘")
 └─ Proprioception: Joint Angles, Gripper State, Force-Torque
         │
         ▼
[ VLA Foundation Backbone ]
 ┌────────────────────────────────────────────────────────┐
 │ Vision Transformer (ViT) + Multimodal LLM Core         │
 │ - Visual Tokenizer & Text Tokenizer                    │
 │ - Cross-Attention & Spatial-Temporal Feature Fusion   │
 │ - Common-sense Reasoning & Task Decomposition          │
 └───────────────────────────┬────────────────────────────┘
                             │
         ┌───────────────────┴───────────────────┐
         ▼                                       ▼
 [ Action Token Generation ]             [ Diffusion Action Policy ]
  - Discrete Token Output                 - Continuous Trajectory Denoising
  - Next-Token Prediction                 - Action Chunking (ACT)
         │                                       │
         └───────────────────┬───────────────────┘
                             ▼
[ Low-level Control & Execution ]
 ┌────────────────────────────────────────────────────────┐
 │ Robot Control Loop (e.g., 10Hz ~ 50Hz)                 │
 │ - End-Effector Delta Pose (Δx, Δy, Δz, Δroll, Δpitch, Δyaw)
 │ - Gripper Binary/Continuous State (Open / Close)       │
 │ - Joint Torque / Velocity Execution                    │
 └────────────────────────────────────────────────────────┘

5. 관련 기술

  • 상위 기술: 파운데이션 모델(Foundation Model), 신체화 인공지능(Embodied AI), 로보틱스(Robotics).
  • 연관 기술: 공간 지능(Spatial Intelligence), 3D Gaussian Splatting, 디지털 트윈(Digital Twin), 월드 모델(World Model).
  • 하위 기술:
  • 대표 모델군: RT-1 / RT-2 (Google DeepMind), OpenVLA, Octo, Eureka.
  • 데이터/플랫폼: Open X-Embodiment (Open X), ROS 2, NVIDIA Isaac Sim / Isaac Lab.
  • 제어 알고리즘: Action Chunking with Transformers (ACT), Diffusion Policy, 모방 학습(Imitation Learning).

6. 비교 기술

비교 항목 전통적 로봇 제어 (Modular Pipeline) 종단간 모방학습 (End-to-End BC) 로봇 파운데이션 모델 (VLA / RFM)
시스템 구조 인식 $\rightarrow$ SLAM $\rightarrow$ 모션플래닝 $\rightarrow$ PID 분립 단일 신경망 기반 단순 입력-출력 매핑 대규모 사전학습 VLM + 액션 토큰 헤드
작업 유연성 사전 정의된 궤적만 수행 (하드코딩) 학습된 단일 작업만 모방 가능 자연어 지시 기반 미확인 작업 제로샷 수행
학습 데이터 제어 궤적 수학 공식 및 센서 필터링 소규모 로봇 원격 조작 궤적 (수백 회) 수백만 건의 다종 로봇 데이터 + 웹 멀티모달
상식적 추론 불가능 (좌표 계산만 수행) 불가능 (시각 특징-액션 단순 상관관계) 가능 (물체의 쓰임새, 공간 관계 문맥 이해)
폼팩터 전이 기구학(Kinematics) 모델 재설계 필수 타 로봇 하드웨어에 적용 불가 Cross-Embodiment 지원 (상이한 하드웨어 흡수)

7. 장점 및 효과

  • 일반화 역량 극대화: 본 적 없는 물체나 조명 환경에서도 의미론적 언어 지시를 해석하여 작업을 유연하게 완수.
  • 프로그래밍 비용 절감: 작업마다 수작업으로 궤적을 캘리브레이션하거나 코딩할 필요 없이 자연어 프롬프트 교체만으로 제어 가능.
  • 지식 전이(Cross-Embodiment): 단일 팔 로봇에서 학습한 집기(Grasping) 기술을 양팔 로봇이나 휴머노이드로 교차 전이 가능.

8. 단점 및 한계

  • 실시간 제어 레이턴시: 수십억 파라미터의 거대 트랜스포머 추론으로 인해 실시간 고속 피드백 루프(100Hz 이상 필수 제어) 충족 난항.
  • 물리적 데이터 희소성: 웹 텍스트/이미지와 달리 로봇 물리 상호작용 데이터(토크, 반발력, 미끄러짐)는 수집 비용이 극도로 높음.
  • 안전성 및 결정론적 보장 부재: 딥러닝 확률적 출력 특성상 오작동 시 물리적 충돌, 인명 사고, 기물 파손의 치명적 위험 존재.

9. 적용 사례

  • 스마트 물류 및 풀필먼트: 비정형 혼합 박스 내 무작위 패키지의 물체 분류(Pick-and-Place) 및 팔레타이징.
  • 제조 라인 정밀 조립: 공차 및 위치 오차가 존재하는 부품의 케이블 결선, 볼트 체결, 유연 부품 조작.
  • 가사 및 서비스 휴머노이드: "식탁 위의 빈 접시를 싱크대로 치워줘"와 같은 일상 복합 명령 자율 수행.

10. 고려사항 (CSF)

  • 계층적 제어 아키텍처(Hierarchical Decoupling): 고수준 VLA 모델(느린 추론: 15Hz)과 저수준 피드백 컨트롤러(빠른 안정화: 100500Hz)의 이원화 분리.
  • 안전 제약 조건(Safety Shielding): VLA 출력 경로 상단에 기구학적 제약 검증 및 충돌 방지 세이프티 가드레일 강제 연동.
  • 합성 데이터 파이프라인(Sim-to-Real): 현실 로봇 데이터 부족을 극복하기 위해 물리 시뮬레이터와 도메인 랜덤화 기법을 통한 대량의 합성 궤적 자동 생성.

11. 발전 방향 및 시사점

  • 공간 지능 및 3D/4D 표현 결합: 2D 픽셀을 넘어 점군(Point Cloud), 3D Voxel, 공간 점유(Occupancy)를 이해하는 3D VLA로 발전.
  • 월드 모델(World Model) 통합: 행동을 취하기 전 물리 법칙에 따라 미래 시각 상태($S_{t+1}$)를 멘탈 시뮬레이션하고 검증하는 자가 계획(Self-Planning) 탑재.
  • 온로봇 경량화(Edge VLA): 양자화, 모델 가지치기(Pruning), 온디바이스 NPU 최적화를 통해 외부 클라우드 통신 없이 기체 자체에서 실시간 자율 구동.

12. 기술 관계도

[전통 로봇 공학] 기구학/동역학 수식 및 파이프라인 분립
  │ (센싱 ➔ 매핑 ➔ 경로계획 ➔ 모터제어 분리, 누적 오차 한계)
  ▼
[초기 딥러닝] 작업별 종단간 모방학습 및 강화학습
  ├─ Behavioral Cloning (원격 조작 궤적 단순 복제)
  └─ Deep RL (시뮬레이션 환경 내 시행착오 기반 보상 극대화)
  ▼
[파운데이션 모델 결합] LLM/VLM을 로봇 상위 플래너로 활용
  ├─ SayCan (LLM이 지침 분해 + 가용도(Affordance) 평가)
  └─ Code as Policies (LLM이 로봇 API 제어 파이썬 코드 생성)
  ▼
[진정한 VLA 태동] Vision-Language-Action End-to-End 통합
  ├─ RT-1 / RT-2 (Google: 액션을 이산 토큰으로 양자화하여 LLM에 내재화)
  ├─ Open X-Embodiment (글로벌 30여 개 연구소의 이기종 로봇 통합 데이터셋)
  └─ Diffusion Policy / ACT (연속 궤적의 다중 모달리티 정밀 생성)
  ▼
[현재~미래] Physical AI 및 차세대 휴머노이드 표준 브레인
  ├─ 3D VLA (공간 지능 및 3D 물리 제어 정합)
  ├─ World Model 기반 사전 시뮬레이션 추론 (물리적 인과관계 예측)
  └─ Generalist Humanoid OS (범용 상용 서비스 로봇 통합 탑재)

출처

  • Google DeepMind: RT-1: Robotics Transformer for Real-World Control at Scale
  • Google DeepMind: RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
  • Open X-Embodiment Collaboration: Open X-Embodiment: Robotic Learning Datasets and RT-X Models
  • Stanford University: Diffusion Policy: Visuomotor Policy Learning via Action Diffusion

1. 한줄 정의

  • 파운데이션 모델 (Foundation Model): 방대한 비라벨링 원시 데이터를 자기지도학습(Self-supervised Learning)으로 사전 학습(Pre-training)하여 구축한 후, 파인튜닝·프롬프팅을 통해 다양한 다운스트림 태스크에 적응(Adaptation) 가능한 대규모 기초 인공지능 모델.
  • 스탠퍼드 HAI(CRFM)에서 정립한 개념으로, 특정 작업 전용 모델을 매번 새로 만드는 패러다임에서 단일 초대형 범용 기반 모델을 하류 작업으로 분기·전이시키는 AI 아키텍처의 패러다임 시프트.


2. 특징, 배경, 목적, 해결

  • 등장 배경: 태스크별 고비용 라벨링 데이터셋 의존(Supervised Learning 한계), 모델 파편화로 인한 비효율, 트랜스포머(Transformer) 구조의 우수한 확장성(Scalability) 검증.
  • 해결 과제: 비라벨링 웹 스케일 데이터를 자기지도 방식으로 흡수하여 풍부한 잠재 표현(Latent Representation)을 구축하고, 최소한의 튜닝(PEFT, 프롬프트 엔지니어링)만으로 다분야 작업 전이 실현.
  • 중요성: 텍스트, 코드, 비전, 음성, 분자 구조 등 전 산업 영역의 AI 개발 비용을 획기적으로 낮추고 멀티모달 범용 인공지능(AGI)으로 향하는 기술적 근간.

3. 핵심 개념

  • Self-supervised Learning: 데이터 자체의 일부를 가려 정답(Ground Truth)으로 삼아 모델 스스로 문맥적 특징을 학습하는 기법(Masked LM, Next Token Prediction).
  • Emergent Abilities (창발적 능력): 모델의 파라미터 수 및 연산량이 임계점(Scale)을 넘어서면 사전 훈련 시 명시적으로 가르치지 않은 추론·연산 역량이 비약적으로 발현되는 현상.
  • In-Context Learning (ICL): 가중치(Weight) 업데이트 없이 프롬프트 입력창 내 소수의 예시(Few-shot) 제공만으로 즉각적인 태스크 적응을 수행하는 메커니즘.
  • Homogenization (동질화): 광범위한 산업·응용 소프트웨어가 소수의 초대형 기반 모델에 종속됨으로써 강점과 취약점(Bias, Hallucination)이 동시에 전파되는 현상.
  • PEFT (Parameter-Efficient Fine-Tuning): 원본 모델 가중치를 고정한 채 일부 저차원 행렬(LoRA, QLoRA)만 학습하여 자원 효율성을 극대화하는 경량 적응 기술.
  • Alignment (정렬): 인간의 윤리적 가치와 의도에 부합하도록 안전성을 보정하는 기법(RLHF, DPO, RLAIF).
  • Multi-modality: 텍스트, 비전, 오디오, 센서 데이터를 공통 잠재 공간(Shared Embedding Space)에 투영하여 교차 추론하는 역량.

4. 동작 원리 / 구조

  • 동작 원리: 웹 스케일 대규모 코퍼스를 수집·정제한 후 트랜스포머 기반 심층 신경망을 통해 사전 학습을 거치고, 이후 특정 목적에 맞게 지도 미세조정(SFT), 인간 피드백 정렬(RLHF), RAG/에이전트 결합을 거쳐 최종 사용자 서비스로 연결됨.
[ Data Source ]
 ┌────────────────────────────────────────────────────────┐
 │ Raw Multi-modal Web Data (Text, Code, Vision, Audio)   │
 └───────────────────────────┬────────────────────────────┘
                             │ Self-Supervised Learning (Next Token / MLM)
                             ▼
[ Pre-trained Foundation Model ]
 ┌────────────────────────────────────────────────────────┐
 │ Dense / MoE Transformer Core (Hundreds of Billions Params)│
 │ - Shared Representation / Emergent Abilities / World Model│
 └───────────────────────────┬────────────────────────────┘
                             │ Adaptation Layer
         ┌───────────────────┼───────────────────┐
         ▼                   ▼                   ▼
 [ Parameter Tuning ]   [ Context Injection ] [ Post-Training ]
  - PEFT (LoRA/QLoRA)    - Prompt Engineering  - SFT (Instruction Tuning)
  - Full Fine-Tuning     - RAG (External DB)   - RLHF / DPO (Alignment)
         │                   │                   │
         └───────────────────┼───────────────────┘
                             ▼
[ Downstream Tasks & Services ]
 ├─ NLP / Translation / Summarization
 ├─ Multi-modal (Image / Video / Audio Gen)
 ├─ Code Generation & Software Engineering
 └─ Autonomous Agents & Robotics Embodiment

5. 관련 기술

  • 상위 기술: 인공지능(AI), 딥러닝(Deep Learning), 생성형 AI(Generative AI).
  • 연관 기술: RAG(검색 증강 생성), AI 에이전트(Agentic AI), 벡터 데이터베이스(Vector DB), 온디바이스 AI(On-device AI).
  • 하위 기술:
  • 아키텍처: Transformer, MoE(Mixture of Experts), State Space Models(Mamba).
  • 사전학습/경량화: DeepSpeed, Megatron-LM, 양자화(AWQ, GPTQ), FlashAttention.
  • 적응/정렬 기술: LoRA, QLoRA, SFT(Supervised Fine-Tuning), DPO(Direct Preference Optimization).

6. 비교 기술

비교 항목 전통적 작업 특화 모델 (Task-specific) 파운데이션 모델 (Foundation Model)
학습 패러다임 지도학습 (Supervised Learning) 중심 자기지도학습 (Self-supervised) 기반 대규모 사전학습
데이터 요구사항 작업별 대량의 고비용 라벨링 데이터 필요 비라벨링 원시 데이터 흡수 후 소량 데이터로 적응
적용 범위 단일 작업 전용 (번역기, 분류기 등 독립 모델) 단일 모델 기반 다목적·멀티모달 다운스트림 확장
인프라/비용 작업별 모델 분립으로 총 관리 비용 증가 사전학습 비용 극대화, 다운스트림 전이 비용 최소화
추론/동작 방식 고정된 함수 매핑 연산 프롬프팅, In-Context Learning, Chain-of-Thought
장애 전파 위험 개별 모델 실패가 시스템 전체로 확산되지 않음 기반 모델의 편향/환각이 모든 하류 서비스로 일괄 전이

7. 장점 및 효과

  • 개발 주기 및 TCO 단축: 새로운 AI 서비스를 개발할 때 바닥부터 학습할 필요 없이 API 호출 및 경량 튜닝(PEFT)만으로 수 주 내 상용화 가능.
  • 우수한 범용 일반화 능력: 도메인 간 교차 추론이 가능하며, 복합 지침(Complex Instruction) 및 제로샷/퓨샷 환경에서 뛰어난 적응력 발휘.
  • 생태계 레버리지 극대화: 단일 기반 모델 위에 플러그인, RAG, 에이전트 도구 연동을 결합하여 플랫폼 형태의 거대 AI 생태계 구축 용이.

8. 단점 및 한계

  • 환각(Hallucination) 및 신뢰성: 통계적 확률에 기반한 토큰 생성 특성상 사실과 다른 그럴듯한 거짓 정보를 생성하는 본질적 한계.
  • 동질화(Homogenization)에 따른 단일 실패점: 전 세계 서비스들이 소수 빅테크 기반 모델을 공유함으로써 단일 보안 취약점이나 알고리즘 편향이 사회 전반에 동시 파급.
  • 인프라 독점 및 지속 가능성: 훈련에 수천~수만 대의 초고가 GPU 클러스터 및 막대한 전력·냉각수가 소모되어 빅테크 중심의 기술 과점 심화.

9. 적용 사례

  • 소프트웨어 공학: GitHub Copilot, Cursor 등 코드 자동 완성, 단위 테스트 생성, 레거시 코드 현대화.
  • 엔터프라이즈 지식 관리: 사내 문서 기반 검색 증강 생성(RAG)을 통한 전문 지식 Q&A 및 보고서 초안 자동화.
  • 의료 및 바이오: AlphaFold, ESM 등 단백질 접힘 구조 예측 및 화합물 스크리닝을 통한 신약 개발 주기 단축.

10. 고려사항 (CSF)

  • 데이터 거버넌스 및 저작권: 사전학습 데이터의 저작권 침해 분쟁 예방, 개인정보(PII) 스크러빙, 데이터 오염(Contamination) 필터링.
  • 안전성 및 정렬(Alignment) 검증: 유해 콘텐츠 생성을 차단하는 레드팀(Red Teaming) 수행, Guardrails 구축, 탈옥(Jailbreak) 방어 체계 수립.
  • 서빙 비용 및 레이턴시 제어: MoE 구조 채택, 서빙 엔진(vLLM, TensorRT-LLM) 최적화, 스펙큘레이티브 디코딩(Speculative Decoding) 도입.

11. 발전 방향 및 시사점

  • MoE(Mixture of Experts) 기반 효율화: 전체 파라미터 중 토큰별로 활성화되는 전문 전문가 네트워크만 구동하여 연산 비용 대폭 절감.
  • 복합 추론(Reasoning) 특화 모델: 강화학습 기반의 MCTS(몬테카를로 트리 탐색) 및 Test-Time Compute 확장을 통해 수학·코딩 등 복합 문제 해결력 강화.
  • SLM(Small Language Model) 및 엣지 배포: 지식 증류(Knowledge Distillation)를 통해 경량화하여 스마트폰, 온프레미스 기기에서 안전하게 독립 구동.

12. 기술 관계도

[초기 딥러닝] 작업별 특화 모델 (Task-specific Modeling)
  │ (Word2Vec, CNN, LSTM - 라벨링 데이터 의존, 모델 파편화)
  ▼
[트랜스포머 태동] Attention All You Need (2017)
  │ (Self-Attention 기반 병렬화 및 확장성(Scalability) 입증)
  ▼
[사전학습 패러다임] Pre-trained Language Models (2018~2020)
  ├─ 인코더 중심 (BERT - MLM 기반 양방향 표현 학습)
  └─ 디코더 중심 (GPT-1/2/3 - Autoregressive 언어 생성)
  ▼
[파운데이션 모델 정립] 스탠퍼드 HAI 개념 체계화 (2021)
  │ (초대형 규모화 ➔ 창발성 발현 ➔ 범용 기반 모델로 표준화)
  ▼
[적응 및 정렬 혁신] LLM 대중화 (2022~2024)
  ├─ SFT 및 RLHF/DPO를 통한 정렬 (ChatGPT, Claude)
  ├─ PEFT(LoRA)를 통한 경량 미세조정 보편화
  └─ LLaMA 계열 오픈소스 파운데이션 모델 확산
  ▼
[현재~미래] 차세대 파운데이션 모델 진화
  ├─ Native Multi-modal (옴니 모델: 텍스트·음성·영상 실시간 통합)
  ├─ Test-Time Reasoning (사고 과정 확장형 심층 추론 모델)
  └─ Agentic Foundation Model (도구 사용 및 환경 상호작용 자율화)

출처

  • Bommasani et al., On the Opportunities and Risks of Foundation Models (Stanford Center for Research on Foundation Models - CRFM)
  • Vaswani et al., Attention Is All You Need (NeurIPS 2017)
  • Hu et al., LoRA: Low-Rank Adaptation of Large Language Models (ICLR 2022)
  • Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model (NeurIPS 2023)

1. 한줄 정의

  • 가치사슬 (Value Chain): 기업이 원자재를 조달하여 최종 제품·서비스를 고객에게 전달하고 사후 지원하기까지 가치를 부가하는 모든 일련의 활동을 체계적으로 분해·분석하는 경영 전략 프레임워크.
  • 마이클 포터(Michael Porter)가 제안한 모델로, 활동을 주 활동(Primary Activities)과 지원 활동(Support Activities)으로 구분하여 기업의 비용 우위(Cost Leadership)와 차별화(Differentiation) 원천을 규명하는 분석 도구.


2. 특징, 배경, 목적, 해결

  • 등장 배경: 기업 내부를 단순한 단일 조직으로 파악하던 블랙박스 관점에서 탈피하여, 개별 단위 활동별 비용 구조와 가치 창출 기여도를 미시적으로 분석할 필요성 대두.
  • 해결 과제: 어느 공정·기능에서 비효율과 비용 낭비가 발생하는지 특정하고, 어떤 고유 활동이 경쟁사 대비 지속 가능한 경쟁 우위(Competitive Advantage)를 만드는지 정량화·가시화.
  • 중요성: ISP(정보전략계획), EA/ITA 아키텍처 수립, ERP/SCM 도입, 디지털 전환(DX) 시 업무 프로세스 혁신(BPR)의 기본 분석 프레임워크로 기능.

3. 핵심 개념

  • Primary Activities (주 활동): 제품의 물리적 생성, 유통, 판매 및 고객 전달과 직결되는 핵심 현업 활동.
  • Support Activities (지원 활동): 주 활동이 원활히 수행되도록 조직 전체를 뒷받침하는 기반 인프라 및 지원 기능.
  • Margin (마진/이윤): 가치사슬 활동을 통해 창출된 총 가치(Customer Willingness to Pay)에서 각 활동 수행에 투입된 총비용을 차감한 순가치.
  • Linkage (연계/상호작용): 가치사슬 내 활동 간 최적화(Optimization) 및 조정(Coordination)을 통해 시너지를 창출하는 관계.
  • Value System (가치 시스템): 공급업체 가치사슬 $\rightarrow$ 기업 가치사슬 $\rightarrow$ 유통 채널 가치사슬 $\rightarrow$ 고객 가치사슬로 이어지는 확장된 공급망 네트워크.
  • Cost Driver / Uniqueness Driver: 각 활동의 원가를 결정짓는 요인(규모의 경제, 학습 곡선 등)과 차별화를 유발하는 동인(품질, 독점 기술 등).
  • Digital Value Chain: 데이터·클라우드·AI 기술을 결합하여 전통적 선형 가치사슬을 분해하고 실시간 상호작용 플랫폼으로 재구성한 형태.

4. 동작 원리 / 구조

  • 구조 및 동작: 하단의 5가지 주 활동이 제품 흐름에 따라 순차 진행되고, 상단의 4가지 지원 활동이 전체 주 활동을 교차 지원하며 최종적으로 기업 마진(Margin)을 창출함.
+-----------------------------------------------------------------------------------+
| 지원 활동 (Support Activities)                                                    |
| ┌───────────────────────────────────────────────────────────────────────────────┐ │
| │ 기업 하부구조 (Firm Infrastructure) : 기획, 재무, 법무, 품질경영, 정보시스템  │ │
| ├───────────────────────────────────────────────────────────────────────────────┤ │
| │ 인적자원 관리 (Human Resource Management) : 채용, 교육훈련, 보상, 노사관리    │ │
| ├───────────────────────────────────────────────────────────────────────────────┤ │
| │ 기술 개발 (Technology Development) : R&D, 제품 설계, 공정 자동화, IT 인프라   │ │  M
| ├───────────────────────────────────────────────────────────────────────────────┤ │  A
| │ 조달 활동 (Procurement) : 원자재 구매, 공급업체 협상, 외주 계약 관리          │ │  R
| └───────────────────────────────────────────────────────────────────────────────┘ │  G
+-----------------------------------------------------------------------------------+  I
| 주 활동 (Primary Activities)                                                      │  N
| ┌─────────────┬─────────────┬─────────────┬──────────────┬──────────────┐         │
| │ 입고 물류   │ 운영/생산   │ 출고 물류   │ 마케팅/판매  │ 서비스       │         │
| │ (Inbound    │ (Operations)│ (Outbound   │ (Marketing & │ (Service)    │         │
| │  Logistics) │             │  Logistics) │  Sales)      │              │         │
| │ 원자재 검수,│ 부품 조립,  │ 주문 처리,  │ 가격 결정,   │ 설치, 유지보수│        │
| │ 입고 적재,  │ 가공, 패키징,│ 배송/출하,  │ 광고/프로모션│ 부품 교체,   │        │
| │ 재고 관리   │ 설비 유지보수│ 배차 계획   │ 영업 채널 관리│ 고객 불만응대│        │
| └─────────────┴─────────────┴─────────────┴──────────────┴──────────────┘         │
+-----------------------------------------------------------------------------------+
  ─────── 가치 흐름 (Value Stream) & 원가 투입 (Cost Input) ───────>

5. 관련 기술

  • 상위 기술: 마이클 포터 5-Forces 모델, 전략 캔버스(Blue Ocean Strategy), 기업 전략론.
  • 연관 기술: BPR(Business Process Reengineering), ISP(Information Strategy Planning), EA(Enterprise Architecture), Lean/Six Sigma.
  • 하위/구현 기술:
  • SCM (Supply Chain Management): 입고·운영·출고 물류의 엔드투엔드 통합 관리.
  • ERP (Enterprise Resource Planning): 지원 활동(재무/인사/구매)과 주 활동의 단일 데이터베이스 통합.
  • CRM (Customer Relationship Management): 마케팅/영업 및 대고객 서비스 가치 극대화.
  • PLM (Product Lifecycle Management): 기술 개발 단계의 제품 수명주기 데이터 통합.

6. 비교 기술

비교 항목 가치사슬 (Value Chain) 공급망 관리 (SCM) 비즈니스 모델 캔버스 (BMC)
분석 관점 단위 활동별 가치 부가 및 마진 창출 원자재부터 소비까지의 물류/정보 흐름 기업의 가치 제안 및 수익 창출 구조
분석 대상 개별 기업 내부 활동 (주/지원 활동) 복수 기업 간 파트너십/유통망 네트워크 고객, 채널, 파트너, 수익원 등 9개 블록
주요 목적 비용 우위 및 차별화 원천 규명 리드타임 단축 및 재고/물류비용 최적화 신규 비즈니스 모델 설계 및 타당성 검증
IT 연계 EA 아키텍처 수립 및 기능 분할 기준 WMS, TMS, 수요예측 알고리즘 연계 스타트업 기획, 디지털 플랫폼 전환 로드맵

7. 장점 및 효과

  • 경쟁력 원천의 가시화: 기업 내 어느 활동에서 원가가 과다하게 발생하는지 또는 차별화 역량이 집중되어 있는지 객관적 식별 가능.
  • IT 투자 타당성 수립: 기업 핵심 가치 창출 활동에 전략적으로 IT 예산(ERP, AI, 클라우드)을 집중 배분하는 의사결정 기준 제공.
  • 프로세스 병목 해소: 활동 간 연계(Linkage) 분석을 통해 부서 간 이기주의(Silo)를 타파하고 전체 최적화 달성.

8. 단점 및 한계

  • 제조업 중심의 한계: 전통적 선형 제조 파이프라인에 최적화되어 있어, 서비스업이나 플랫폼 비즈니스의 양면 시장(Two-sided Market) 설명 한계.
  • 활동 간 경계 모호성: 디지털 융합 환경에서 개발(기술개발)과 운영(생산)의 경계(예: DevOps)가 허물어지는 현상을 정적으로만 표현.
  • 데이터 네트워크 효과 배제: 사용자 수 증가가 가치를 폭발시키는 플랫폼 비즈니스의 피드백 루프(Flywheel Effect) 반영 불가.

9. 적용 사례

  • 대규모 제조 엔터프라이즈: 스마트 팩토리(Smart Factory) 구축 시 입고-생산-출고 물류 전반의 IoT 센싱 및 설비 예지보전 연계.
  • 공공/엔터프라이즈 EA 수립: 비즈니스 아키텍처(BA) 수립 시 업무 기능 분할도(BRM) 작성을 위한 최상위 메타 모델로 활용.
  • 글로벌 유통 기업(Zara, 쿠팡 등): 입고 물류와 자체 풀필먼트(출고 물류)를 직접 내재화하여 리드타임을 수일 단위로 압축하는 극단적 차별화.

10. 고려사항 (CSF)

  • 내부 연계(Internal Linkage) 최적화: 기술 개발(설계 단순화) 활동과 운영(조립 공정 시간 단축) 활동 간의 설계 단계 연계(DFM) 확립.
  • 외부 연계(Vertical Linkage) 확장: 1차 벤더 및 유통업체 시스템과 API 기반 실시간 연동을 통한 채찍 효과(Bullwhip Effect) 방지.
  • 디지털 가치사슬 재정의: 단순 자동화를 넘어 데이터 파이프라인 중심의 디지털 가치 네트워크로의 프로세스 리엔지니어링.

11. 발전 방향 및 시사점

  • 선형 사슬에서 가치 네트워크(Value Network)로의 전환: 공급자와 수요자가 다대다(N:M)로 상호작용하는 에코시스템 플랫폼 모델로 진화.
  • 지능형 가치사슬(Cognitive Value Chain): 생성형 AI 및 디지털 트윈(Digital Twin)을 활용하여 수요 예측부터 물류 배차까지 전 과정을 자율 제어.
  • ESG 및 순환 경제(Circular Economy): 폐기 단계 이후 회수·재활용을 포괄하는 역물류(Reverse Logistics) 기반 폐루프(Closed-loop) 가치사슬로 확장.

12. 기술 관계도

[1985년] 마이클 포터의 선형 가치사슬 (Value Chain) 정립
  │ (제조업 중심: 주 활동 5개 + 지원 활동 4개 ➔ Margin 산출)
  ▼
[1990s~2000s] 엔터프라이즈 IT 솔루션을 통한 가치사슬 자동화
  ├─ ERP (지원 활동 및 내부 프로세스 통합)
  ├─ SCM (공급망 및 입·출고 물류 최적화)
  └─ CRM (마케팅, 영업, 고객 서비스 통합)
  ▼
[2010s] 디지털 플랫폼 및 생태계 확장
  ├─ 가치 네트워크 (Value Network): 양면 시장 및 플랫폼 비즈니스
  └─ Open API 기반 산업 간 가치사슬 해체 및 재결합 (Unbundling & Rebundling)
  ▼
[현재~미래] 지능형·순환형 디지털 가치사슬
  ├─ Cognitive Value Chain: AI/디지털 트윈 기반 자율 최적화
  └─ Circular Value Chain: ESG 대응 역물류 및 순환 경제 체계 구축

출처

  • Michael E. Porter, Competitive Advantage: Creating and Sustaining Superior Performance (The Free Press)
  • Harvard Business Review: Pipelines, Platforms, and the New Rules of Strategy (Van Alstyne et al.)
  • Gartner Research: Top Strategic Technology Trends: Digital Value Chain & Composable Business

1. 한줄 정의

  • PIM (Processing-In-Memory): 메모리 내부(다이, 뱅크 경계 또는 버퍼 계층)에 프로세서 연산 로직(ALU)을 직접 통합하여 데이터 이동을 최소화하는 지능형 메모리 반도체 아키텍처.
  • CPU/GPU와 메모리 간 시스템 버스를 경유하는 대규모 데이터 왕복 오버헤드를 줄여 폰 노이만 병목을 극복하고 대역폭 및 에너지 효율을 극대화하는 기술.


2. 특징, 배경, 목적, 해결

  • 등장 배경: LLM 추론, 추천 시스템, 그래프 연산 등 Memory-Bound 워크로드 급증으로 프로세서 연산 성능과 메모리 전송 대역폭 간 격차(Memory Wall) 심화.
  • 해결 과제: 데이터 버스 병목 제거, I/O 전력 소모(Power Wall) 절감, 내부 뱅크 레벨 병렬 처리(Bank-Level Parallelism) 활용 극대화.
  • 중요성: 데이터센터 랙 전력 밀도 포화 문제를 완화하고 고비용 가속기(GPU/NPU) 클러스터의 TCO(총소유비용)를 절감하는 차세대 AI 메모리 솔루션.

3. 핵심 개념

  • Bank-Level Parallelism: DRAM 내부 각 뱅크(Bank)에 매핑된 연산 유닛이 독립적으로 동시 연산을 수행하는 구조.
  • SIMD ALU / FPU: FP16/Bfloat16 등 AI 추론에 특화된 벡터 덧셈, 곱셈, MAC 연산 전용 마이크로 엔진.
  • ISA Extension / Custom Instruction: 호스트 CPU/GPU가 PIM 연산 유닛을 제어하기 위한 전용 메모리 매핑 명령 집합(예: FP_ENV, V_ADD, V_MUL).
  • Buffer/Base Die: HBM 하단 로직 계층을 활용해 연산 유닛 및 라우팅 회로를 집적하는 물리적 3D 적층 구조.
  • Processing-Near-Memory (PNM): 메모리 셀 내부가 아닌 모듈 기판, DIMM, CXL 컨트롤러 인근에 가속기를 배치하는 근접 메모리 연산 방식.
  • Memory Coherency: 호스트 캐시와 PIM 연산 영역 간의 데이터 일관성을 보장하기 위한 하드웨어/소프트웨어 프로토콜.

4. 동작 원리 / 구조

  • 동작 원리: 호스트가 메모리에 명령어를 발행하면 PIM 제어기가 DRAM 뱅크 내부 데이터를 외부 버스로 인출하지 않고, 인접한 내부 ALU로 로드하여 즉시 연산 후 결과를 메모리 셀에 재기록(Write-back)하거나 호스트에 최종 축약값만 반환함.
+-----------------------------------------------------------+
| Host Processor (CPU / GPU / NPU)                          |
+-----------------------------┬-----------------------------+
                              │ Host Memory Bus / CXL / PCIe
+-----------------------------▼-----------------------------+
| PIM Memory (e.g., HBM-PIM / LPDDR-PIM Architecture)       |
|                                                           |
| ┌───────────────────────────────────────────────────────┐ |
| │ Command Decoder & Instruction Dispatcher              │ |
| └───────────────────────────┬───────────────────────────┘ |
|                             │                             |
|      ┌──────────────────────┴──────────────────────┐      |
|      ▼                                             ▼      |
| ┌─────────────────────────┐   ┌─────────────────────────┐ |
| │ DRAM Bank 0             │   │ DRAM Bank 1             │ |
| │ ┌─────────────────────┐ │   │ ┌─────────────────────┐ │ |
| │ │ Memory Cell Array   │ │   │ │ Memory Cell Array   │ │ |
| │ └──────────┬──────────┘ │   │ └──────────┬──────────┘ │ |
| │            │ Internal   │   │            │ Internal   │ |
| │            ▼ Bus        │   │            ▼ Bus        │ |
| │ ┌─────────────────────┐ │   │ ┌─────────────────────┐ │ |
| │ │ SIMD ALU / MAC Unit │ │   │ │ SIMD ALU / MAC Unit │ │ |
| │ └─────────────────────┘ │   │ └─────────────────────┘ │ |
| └─────────────────────────┘   └─────────────────────────┘ |
|                              ...                          |
+-----------------------------------------------------------+

5. 관련 기술

  • 상위 기술: 도메인 특화 아키텍처(DSA), 비(非) 폰 노이만 컴퓨팅, 이종 컴퓨팅(Heterogeneous Computing).
  • 연관 기술: CXL(Compute Express Link), HBM3/HBM4, 3D TSV 패키징, 칩렛(Chiplet), High-Bandwidth Interconnect.
  • 하위 기술:
  • HBM-PIM: 3D 적층 HBM 메모리 다이 및 베이스 다이 내 연산 코어 통합(예: 삼성 Aquabolt-XL).
  • AiM (Accelerator-in-Memory): GDDR6 기반 고속 그래픽 메모리 내부 MAC 연산기 통합(예: SK하이닉스 AiM).
  • CXL-PNM: CXL 메모리 확장 모듈 컨트롤러 단에서 가속 연산 오프로딩.
  • PIM 컴파일러/런타임: PyTorch, TVM, ONNX 모델 그래프에서 PIM 오프로드 연산자를 분할·매핑하는 컴파일 체인.

6. 비교 기술

비교 항목 범용 프로세서 (GPU/NPU) Processing-In-Memory (PIM) In-Memory Computing (IMC)
연산 위치 독립 연산 실리콘 칩 메모리 다이 내부/로직 계층 메모리 셀 어레이 (Crossbar/Bitline)
연산 메커니즘 고성능 디지털 SIMD/Tensor 소형 디지털 ALU/MAC 엔진 옴/키르히호프 법칙 기반 아날로그 VMM
데이터 이동 외부 메모리 버스 왕복 메모리 내부 로컬 버스 순환 데이터 이동 전무 (In-situ 계산)
연산 정밀도 완벽한 디지털 (FP32/FP64/INT8) 완벽한 디지털 (FP16/BF16/INT8) 아날로그 잡음/변동성에 따른 오차 발생
제조 공정 선단 로직 공정 (3nm/4nm) 메모리 공정 + 로직 하이브리드 특수 NVM 공정 (RRAM/MRAM)
주요 워크로드 Compute-Bound (행렬 곱 GEMM) Memory-Bound (GEMV, Softmax, 배치=1) 극저전력 엣지 AI, 지속 추론

7. 장점 및 효과

  • 대역폭 확장 및 병목 해소: DRAM 내부의 초광대역 데이터 패스를 직접 사용하여 외부 핀(Pin) 대역폭 한계 극복.
  • 전력 소모 및 탄소 배출 절감: 외부 I/O 인터페이스 구동 전력을 배제하여 최대 50~70% 수준의 전력 절감 달성.
  • 기존 메모리 폼팩터 호환: 표준 JEDEC 핀맵 및 프로토콜 규격을 최대한 준수하여 기존 서버 소켓 인프라 활용 가능.

8. 단점 및 한계

  • 공정 트레이드오프(Cost/Area): DRAM 공정에 고속 로직 트랜지스터를 구현할 때 누설 전류 증가 및 면적당 용량 밀도(Capacitance) 저하.
  • 발열 제어(Thermal Throttling): 메모리 리프레시(Refresh) 특성이 고온에 취약한 상태에서 연산 로직의 자체 발열 가중.
  • 소프트웨어 툴체인 및 표준화 부재: CUDA와 같은 지배적 생태계 부재, 컴파일러 자동 최적화 및 프로그래밍 모델 파편화.

9. 적용 사례

  • LLM 생성 단계(Generation/Decoding): 배치 크기가 1인 환경에서 자기회귀 토큰 생성 시 Weight Loading 병목 가속.
  • 대규모 개인화 추천 시스템(DLRM): 테라바이트급 임베딩 테이블 조회(Embedding Bag) 및 벡터 집계 연산 오프로딩.
  • 음성/비전 온디바이스 AI: 모바일 LPDDR-PIM을 통한 저전력 실시간 온디바이스 음성 인식 및 이미지 분할.

10. 고려사항 (CSF)

  • 메모리 셀 밀도 손실 최소화: 연산 유닛 삽입에 따른 DRAM 용량 감소 비율을 5~10% 이내로 억제하는 회로 설계.
  • 캐시 일관성(Coherency) 및 가상 주소 변환: 호스트 MMU 가상 주소를 PIM 물리 주소로 고속 변환하고 캐시 플러시 오버헤드를 차단하는 아키텍처 지원.
  • 표준화 인터페이스 주도: JEDEC, CXL 컨소시엄을 통한 PIM 명령 표준화 및 오픈소스 런타임 프레임워크 생태계 확보.

11. 발전 방향 및 시사점

  • HBM4 베이스 다이 선단 공정 전환: HBM4부터 베이스 다이에 TSMC 선단 파운드리 로직 공정이 도입됨에 따라 PIM 연산 유닛의 집적도 및 성능 급증.
  • CXL 패브릭 연계형 PIM (CXL-PIM): CXL Switch를 통해 수십 테라바이트급 공유 메모리 풀 내에서 분산 PIM 연산을 수행하는 스케일아웃 구조로 진화.
  • 하이브리드 AI 파이프라인 정립: Prefill(프롬프트 처리) 단계는 GPU Tensor Core가 담당하고, Decoding(토큰 생성) 단계는 PIM이 전담하는 이원화 서빙 파이프라인 표준화.

12. 기술 관계도

[폰 노이만 컴퓨팅] 
  │ (연산-저장 분리, 대규모 AI 워크로드에서 Memory Wall 발생)
  ▼
[대역폭 확장 단계]
  ├─ 2.5D 패키징 기반 HBM (High Bandwidth Memory)
  └─ PCIe 버스 확장형 CXL (Compute Express Link)
  ▼
[Processing-Near-Memory (PNM)]
  ├─ CXL 모듈 및 메모리 버퍼 단 가속기 배치 (DIMM/Board 레벨)
  └─ 데이터 이동 경로 단축, 호스트 부하 경감
  ▼
[Processing-In-Memory (PIM)]
  ├─ Bank-Level PIM: HBM/DRAM 뱅크 내부 ALU 통합
  └─ Sub-Array Level PIM: 연산 단위 미세화 및 초병렬 처리
  ▼
[차세대 메모리 연산 융합]
  ├─ HBM4 선단 로직 다이 기반 고성능 Custom PIM
  ├─ CXL 패브릭 기반 분산 공유 PIM 풀링
  └─ In-Memory Computing (아날로그 크로스바 기반 True IMC)

출처

  • IEEE Micro: Aquabolt-XL: Samsung HBM2-PIM with In-Memory Processing for AI Acceleration
  • JEDEC Solid State Technology Association: Standards for Processing-In-Memory (PIM) Architectures
  • SK hynix White Paper: AiM (Accelerator-in-Memory) Architecture and LLM Acceleration

'IT 토픽 > CA\OS' 카테고리의 다른 글

IMC (In-Memory Computing)  (0) 2026.11.04
SSD (Solid State Drive)  (0) 2026.11.02
CPU 스케줄링  (0) 2026.10.31
오브젝트 스토리지(Object Storage)  (0) 2026.10.25
파일 스토리지 (File Storage)  (0) 2026.10.25

1. 한줄 정의

  • IMC (In-Memory Computing): 연산 장치(CPU/GPU)와 저장 장치(Memory)를 물리적으로 분리하던 폰 노이만 구조에서 벗어나, 데이터가 상주하는 메모리 내부에서 직접 연산을 수행하는 차세대 비(非) 폰 노이만 아키텍처.
  • 대규모 데이터 이동에 따른 버스 병목(Memory Wall)과 전력 소모(Power Wall)를 원천 차단하여 극도의 에너지 효율성과 초고속 병렬 처리를 달성하는 컴퓨팅 기술.


2. 특징, 배경, 목적, 해결

  • 등장 배경: LLM, 딥러닝 등 대규모 AI 워크로드 급증으로 인해 프로세서-메모리 간 데이터 전송 대역폭 한계 및 인터커넥트 전력 소모 폭증.
  • 해결 과제: 데이터 이동 거리 및 횟수를 '0'에 가깝게 수렴시켜 폰 노이만 병목(Memory Wall)과 에너지 장벽(Power Wall) 동시 해소.
  • 중요성: 테라플롭스(TFLOPS) 단위를 넘어 초저전력 엣지 디바이스 및 하이퍼스케일 AI 데이터센터(AIDC)의 에너지 효율 지표(TOPS/W)를 혁신하는 핵심 인프라 기술.

3. 핵심 개념

  • Memory Wall: 프로세서의 연산 속도 증가율 대비 메모리 대역폭/지연시간 개선율의 구조적 격차로 발생하는 병목 현상.
  • PIM (Processing-In-Memory): 메모리 다이(Die) 또는 로직 다이에 연산 유닛(ALU)을 통합 배치하여 메모리 내부에서 연산을 분담하는 구조.
  • PNM (Processing-Near-Memory): HBM의 버퍼 다이 또는 CXL 컨트롤러 등 메모리와 극도로 인접한 위치에 연산 가속기를 배치하는 방식.
  • Analog IMC (Crossbar Array): 멤리스터(RRAM), PRAM, MRAM 등의 물리적 옴의 법칙($I=V/R$) 및 키르히호프 법칙($I=\sum I_i$)을 이용한 초고속 VMM(Vector-Matrix Multiplication) 아날로그 연산.
  • Digital IMC (SRAM/DRAM 기반): 메모리 셀 어레이의 비트라인(Bitline) 레벨에서 불리언 로직(AND, OR, XOR) 및 MAC 연산을 디지털 방식으로 직접 수행.
  • TOPS/W: 1와트(Watt) 전력당 수행 가능한 테라(Tera) 연산 수로 나타내는 에너지 효율 척도.

4. 동작 원리 / 구조

  • 동작 원리: 데이터를 호스트 CPU/GPU 레지스터로 읽어오는 대신, 메모리 내부 크로스바 어레이에 가중치(Weight)를 고정(Stationary)해 두고 입력 전압 벡터($V$)를 인가하여 전류의 합($\sum I$)으로 행렬 곱셈을 1클록 사이클에 도출함.
[ Host Processor (Host CPU/GPU) ]
       │ (High-level Instruction / Graph Scheduling)
       ▼
+-----------------------------------------------------------+
| In-Memory Computing Chip (e.g., Crossbar Array Structure) |
|                                                           |
|       Input Vector (V1, V2, ..., Vn) [DAC Input]          |
|                 │         │         │                     |
|                 ▼         ▼         ▼                     |
|  Wordline 1 ───[ G11 ]───[ G12 ]───[ G13 ] ──> I1 = Σ V*G |
|  Wordline 2 ───[ G21 ]───[ G22 ]───[ G23 ] ──> I2 = Σ V*G |
|  Wordline 3 ───[ G31 ]───[ G32 ]───[ G33 ] ──> I3 = Σ V*G |
|                 │         │         │                     |
|                 ▼         ▼         ▼                     |
|              Bitline 1 Bitline 2 Bitline 3                |
|                 │         │         │                     |
|                 ▼         ▼         ▼                     |
|  [ Peripheral Circuits: Sense Amp / ADC Engine / Reg ]    |
+-----------------------------------------------------------+
       │ (Output Feature Map Data Return)
       ▼
[ Local Buffer / Interconnect Bus ]

5. 관련 기술

  • 상위 기술: 도메인 특화 아키텍처(DSA), 뉴로모픽 컴퓨팅(Neuromorphic Computing), 이종 컴퓨팅(Heterogeneous Computing).
  • 연관 기술: CXL(Compute Express Link), HBM-PIM, 3D V-NAND/다층 3D 스태킹, 양자화(Quantization, INT8/FP4).
  • 하위 기술:
  • 소자 레벨: RRAM(Resistive RAM), MRAM(Magnetic RAM), PRAM(Phase-Change RAM), FeFET.
  • 회로 레벨: DAC/ADC(Analog-to-Digital Converter), Sense Amplifier, Charge Pump.
  • 컴파일러/SW: PIM 가속 컴파일러, TVM/ONNX 기반 그래프 분할 및 매핑 엔진.

6. 비교 기술

비교 항목 폰 노이만 (CPU/GPU) Processing-Near-Memory (PNM) In-Memory Computing (IMC)
연산 위치 전용 연산 코어 (ALU/Tensor Core) 메모리 인접 로직 다이 (CXL/Base Die) 메모리 어레이 내부 (Bitline/Cell)
데이터 이동 PCIe/메모리 버스 왕복 (지연/전력 큼) 초단거리 TSV/인터포저 이동 이동 배제 (In-situ 연산)
연산 방식 고정밀 디지털 연산 (FP32/FP64) 표준 디지털 연산 유닛 적용 물리 법칙 기반 아날로그/혼합 신호 VMM
에너지 효율 보통 (1~10 TOPS/W) 양호 (10~30 TOPS/W) 극대화 (수십~수백 TOPS/W)
연산 정밀도 매우 높음 (오차 없음) 매우 높음 소자 노이즈/변동성으로 오차 발생 가능
주요 적용처 범용 연산, 복합 분기 처리 대규모 추천 시스템, 벡터DB 가속 Edge AI 추론, 초저전력 행렬 연산

7. 장점 및 효과

  • 에너지 효율 극대화: 전체 AI 연산 에너지 소비의 60~80%를 차지하는 데이터 버스 이동 에너지를 제거하여 배터리 제약 환경에 적합.
  • 초병렬 행렬 연산: 크로스바 어레이를 통해 $\mathcal{O}(1)$ 또는 극소 클록 내에 $N \times N$ VMM(Vector-Matrix Multiplication) 연산 병렬 수행.
  • 지연시간(Latency) 단축: 외부 I/O 트랜잭션 오버헤드가 배제되어 실시간 인터럽트 및 엣지 센서 데이터 즉각 처리 가능.

8. 단점 및 한계

  • 연산 정밀도 저하 (Analog Imperfection): 아날로그 IMC의 경우 공정 미세화에 따른 공정 변동(PVT), 소자 간 저항 드리프트, 열 잡음으로 인한 연산 오차 발생.
  • ADC/DAC 면적 및 전력 오버헤드: 아날로그 연산 결과를 디지털로 변환하는 변환기가 칩 면적의 50% 이상, 전체 전력의 다수를 차지하는 역전 현상.
  • 소프트웨어 생태계 부재: 기존 CUDA, PyTorch 등 디지털 폰 노이만 표준 프레임워크와의 직접 호환성 부족 및 특화 컴파일러 요구.

9. 적용 사례

  • 초저전력 온디바이스 AI: 웨어러블, 스마트 워치, 보청기 등의 상시 음성 인식(KWS) 및 센서 퓨전 이상 탐지.
  • 지능형 센서(PIM Sensor): 스마트 CIS(CMOS Image Sensor) 픽셀 단에서 원천 이미지를 읽는 즉시 객체 분류 수행.
  • 자율주행/로보틱스 엣지: 비전 기반 SLAM 및 장애물 회피 연산을 센서 로컬 메모리에서 지연시간 없이 추론.

10. 고려사항 (CSF)

  • 하드웨어-알고리즘 Co-Design: 아날로그 비이상성(Noise)에 강건한 양자화 인식 훈련(QAT, Quantization-Aware Training) 기법 적용.
  • 혼합 신호 변환(ADC) 최적화: 멀티레벨 셀(MLC) 설계 시 비트 분해능(Resolution)과 ADC 면적 간의 트레이드오프 설계.
  • 소프트웨어 툴체인 구축: 호스트 코드 중 IMC 오프로드 영역을 자동 식별하여 그래프를 분할하는 커스텀 컴파일러 스택 확보.

11. 발전 방향 및 시사점

  • 차세대 비휘발성 메모리(NVM) 융합: 플래시/DRAM의 내구성 한계를 극복하는 RRAM, MRAM 기반 비휘발성 IMC로 Standby 전력 제로화.
  • CXL 및 모듈러 스케일아웃: CXL 풀링 메모리 컨트롤러에 IMC/PNM을 통합하여 대규모 LLM 추론 클러스터의 메모리 용량-연산 동시 확장.
  • 디지털-아날로그 하이브리드 IMC: 중요 연산은 디지털 로직으로 무손실 처리하고, 대용량 가중치 곱셈은 아날로그로 가속하는 이원화 구조 채택.

12. 기술 관계도

[1945~현재] 전통적 폰 노이만 아키텍처
  │ (CPU/GPU 중심, 버스 대역폭 한계: Memory Wall & Power Wall 심화)
  ▼
[초기 대응] 메모리 대역폭 확장 (Near-Memory)
  ├─ 2.5D/3D 스택 HBM (High Bandwidth Memory)
  └─ CXL (Compute Express Link) 기반 버스 확장
  ▼
[1단계 발전] Processing-Near-Memory (PNM)
  ├─ HBM-PIM (버퍼 다이에 연산 유닛 탑재, 삼성 Aquabolt-XL)
  └─ CXL-PIM (스마트 CXL 메모리 컨트롤러 연산 오프로딩)
  ▼
[2단계 발전] True In-Memory Computing (IMC)
  ├─ Digital IMC: SRAM/DRAM 비트라인 레벨 로직 연산
  └─ Analog IMC: NVM(RRAM/MRAM) 크로스바 어레이 기반 물리법칙 VMM 가속
  ▼
[미래] 뇌 모사 및 범용 도메인 특화 아키텍처
  ├─ Neuromorphic Chip (스파이킹 신경망 SNN 결합)
  └─ Software-Defined In-Memory Fabric

출처

  • IEEE Micro: A Survey of In-Memory Computing Architectures for Deep Learning
  • Samsung Electronics: HBM-PIM (Processing-in-Memory) Architecture and Performance Evaluation
  • ACM Computing Surveys: Processing-in-Memory: A Workload-Driven Perspective

'IT 토픽 > CA\OS' 카테고리의 다른 글

PIM (Processing-In-Memory)  (0) 2026.11.04
SSD (Solid State Drive)  (0) 2026.11.02
CPU 스케줄링  (0) 2026.10.31
오브젝트 스토리지(Object Storage)  (0) 2026.10.25
파일 스토리지 (File Storage)  (0) 2026.10.25

+ Recent posts